万字长文解读LLM Agent:总体框架、经典论文与实践
这周暂时停更一周大模型RL,因为有实际的需求,所以这周写了一下LLM Agent的综述,之后会继续更新RL的内容~
这篇文章是LLM Agent的基础综述,包括:
- 基本概念和总体框架
- 通过三篇经典论文了解LLM Agent的发展趋势
- LLM Agent实践:数据构建和Chat template设计
我们开始今天的内容吧!
本文共计1.3w字,预计阅读时间30分钟。
“为了达到目的,亚哈必须使用工具;而天底下所有可供使用的工具中,人这个工具是最容易失控的。”——《白鲸》,赫尔曼 · 梅尔维尔
0x01. 基本概念
(1)什么是工具?
**只要能够让语言模型从外部获得知识、或者执行操作的接口,都可以视为工具。**这些“工具”可以是一个检索引擎、一个代码执行器、一个地图 API、一个天气 API、一个与数据库交互的接口等等。
(2)为什么要使用工具?
当前大模型已经具备了很多能力,也具备了很强的理解和解决问题能力(比如内容创作、语言理解、代码生成等),但是依旧无法完成很多复杂的任务。这是因为:
首先,纯LLM的知识固化于训练语料中,一旦涉及世界最新资讯或时效性较强的数据(如天气、新闻、股票),LLM 往往会产生“幻觉”。因此相比其他确定性的工具,LLM是“最容易失控的”。这时候,通过整合搜索引擎、在线数据库、知识库等工具,模型能获得真实世界的知识和反馈,在回答用户实时问题时具有更高的准确度与时效性。
举例来说,检索增强式生成(Retrieval-Augmented Generation,RAG)就是最常见的工具之一:检索引擎可看作是一个“文本搜索”工具,我们在用户与LLM交互的时候,让LLM能够从外挂知识库中实时检索,引入丰富且正确的外部知识,避免“幻觉”式回答。
其次,大模型虽在通用场景下表现出色,但当问题需要专业技能(如复杂逻辑推理、多语言编程、多模态生成)时,仅靠自身生成的能力难以解决。如果能“外呼”专业工具(如真实执行代码、调用多模态模型等),则能大幅提升表现。
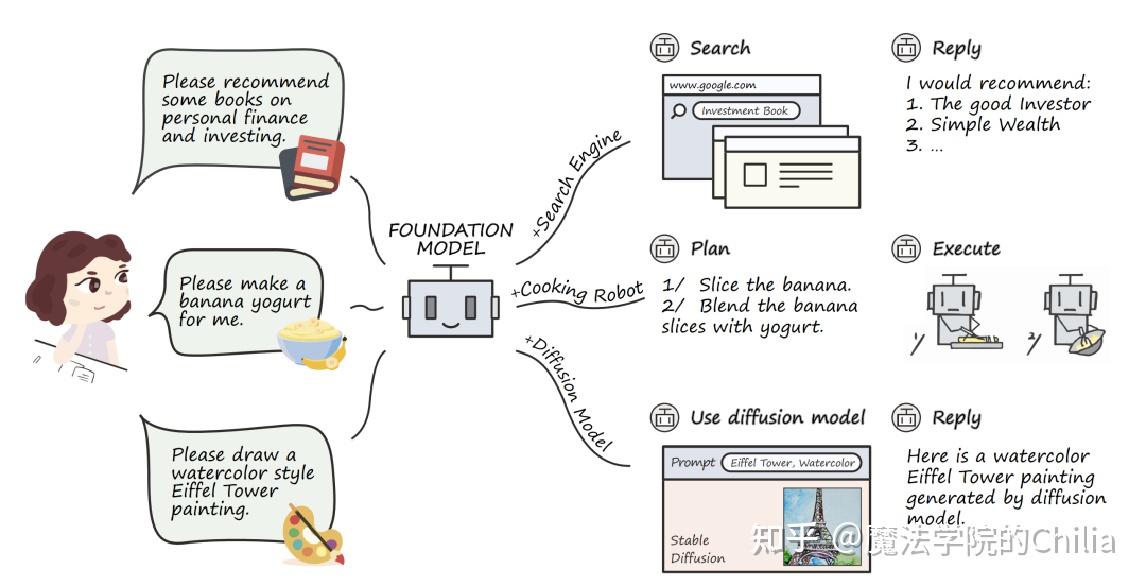
tool的类型多种多样,它们能够帮助LLM完成自己本身做不到的事情
(3)Agent基本介绍
AGENT = LLM × (规划+记忆+工具)
在这篇文章中,我们会对Agent的每个环节做较为详细的介绍。先把架构图放在这里,以便有一个整体的认知。
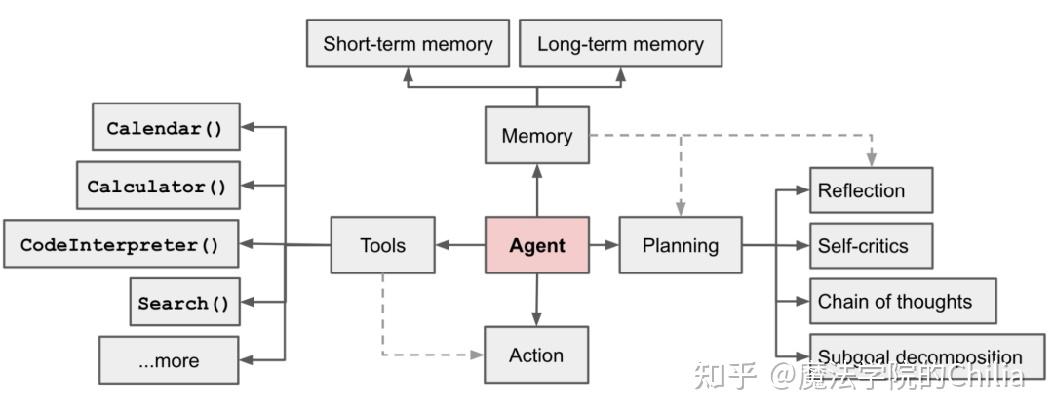
在这篇文章中,我们会详细介绍:
- 规划(Planning):如何将大型任务分解为较小的、可管理的子目标,以便高效的处理复杂任务;
- 反思与自我修正(Reflection & Self-critics):如何对过去的行为进行自我批评和反省,并指导接下来的行动
- 记忆(Memory)
- 短期记忆:依赖模型上下文窗口的短期记忆能力;
- 长期记忆:长期保存和调用无限信息的能力,一般通过外部载体存储和快速检索来实现。(本文不细讲)
- 工具使用(Tool use):如何调用外部 API,以获取模型权重中缺少的额外信息。
(4)Agent的不同阶段
在这里也是先放一个整体的图,以便有整体的认知。之后我们会通过经典论文和实操来了解更具体的细节。
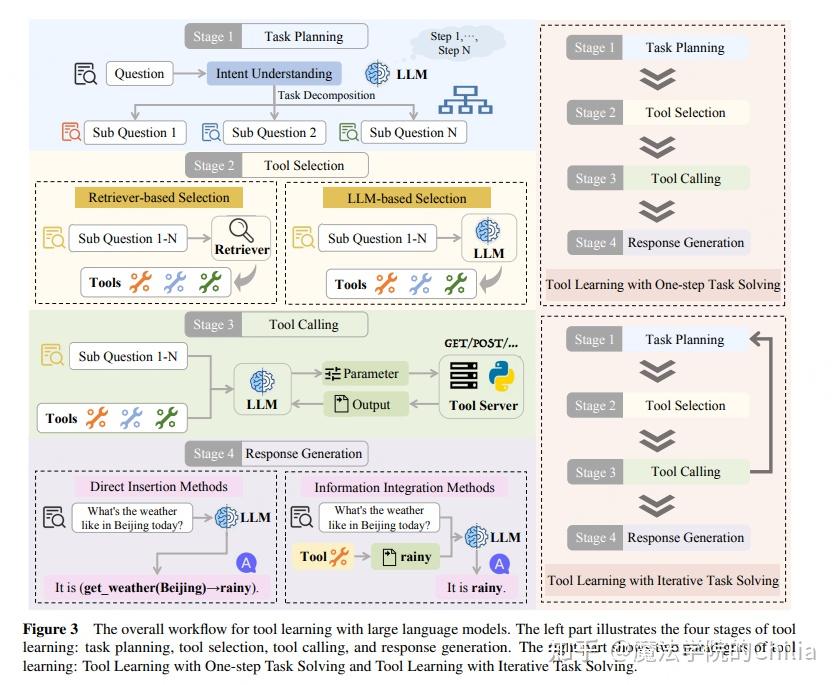
Stage 1:Task-Planning
任务规划是指,当模型接收到用户的复杂query后,需要先进行意图理解与任务分解。先把整个问题分解成若干容易执行的小任务或步骤,并确定这些步骤的依赖关系和执行顺序,形成一个有向无环图(DAG)。
Stage 2: Tool Selection
在完成任务分解、明确了子问题后,模型需要在多个可用的工具(或API)中检索并选择最合适的工具。不同工具往往功能、输入输出方式都不同,因此正确选择不同工具组合对于成功解决子任务至关重要。
工具选择的方法也分成两类:
- **基于检索器的工具选择(Retriever-based Tool Selection)。**当工具数目庞大时,先用一个外部的检索器来筛选Top-K可能相关的工具,再把它们的描述与用户问题一并输入LLM,最终由LLM做最后的选择。这是因为模型能接受的上下文长度是有限的,如果把所有的工具都堆给它,直接就超出了上下文长度,这样肯定是不行的。常见的检索方法包括多种传统IR技术(TF-IDF/BM25)或者语义向量检索。
- **基于LLM的直接选择(LLM-based Tool Selection)**当备选的工具数量不是很多时,可以直接把工具描述全部拼接进模型输入,让LLM选出最优工具。
Stage3:Tool-Calling
在选定要用的工具后,LLMs 需要以正确的格式向工具发送调用请求,并准确填充调用参数。需要遵循工具说明中要求的格式(如参数名称、变量类型、取值范围等),否则调用会失败。
按照种类来分,工具调用分为:
- 单工具调用(Single Function Call): 如“今天天气怎么样”-> 调用
get_weather - 依赖性工具调用(Dependent Function Call):如“张三的地址处天气怎么样?”-> 先调用
get_address,然后调用get_weather - 平行工具调用(Parallel Function Call):如“张三的手机号和地址是多少?”-> 同时调用
get_address、get_phone_number
Stage4:Response Generation
工具调用完成后,LLM会收到工具调用结果,这个结果称为 Observation。接下来需要基于这个Observation与自身知识,生成最终回答给用户。
- **直接插入式(Direct Insertion Methods):**这是最简单的办法,如让模型回答时先写一句“这里是工具返回结果:ToolResult()”,然后在呈现给用户前,将“ToolResult()”替换成实际工具输出文本。这种方式往往不够灵活,也可能影响可读性,所以目前使用较少。
- **信息整合式(Information Integration Methods):**先将Observation作为上下文,继续输入LLM,让它基于这个信息写出完整、自然的答案。若工具输出过长,超出LLM的上下文窗口,会先对工具结果进行压缩或抽取。
0x02. 经典论文
(1)React(2022):奠定Agent“思考”与“行动”相结合的范式
REACT: SYNERGIZING REASONING AND ACTING IN LANGUAGE MODELS
这篇系统性地提出了将 Reasoning 与 Acting 结合的范式,也就是我们现在熟知的ReAct模式。
在 ReAct 模式提出之前,LLM的推理主要分为如下两个模式:
- 推理(Reasoning):例如 Chain-of-Thought (CoT),模型利用内部知识直接输出答案。但是这个的缺点就是模型容易产生幻觉,且无法获取外部世界的实时信息。例如问LLM“现在的美国总统是谁”,它不能实时联网搜索,用的知识都停留在训练时候的老旧数据。
- 行动(Acting): 模型根据tool-call的执行结果(Observation)直接输出下一个动作(Action)。比如下图的(1c)中,每次都根据上一轮的Observation来生成下一个动作。
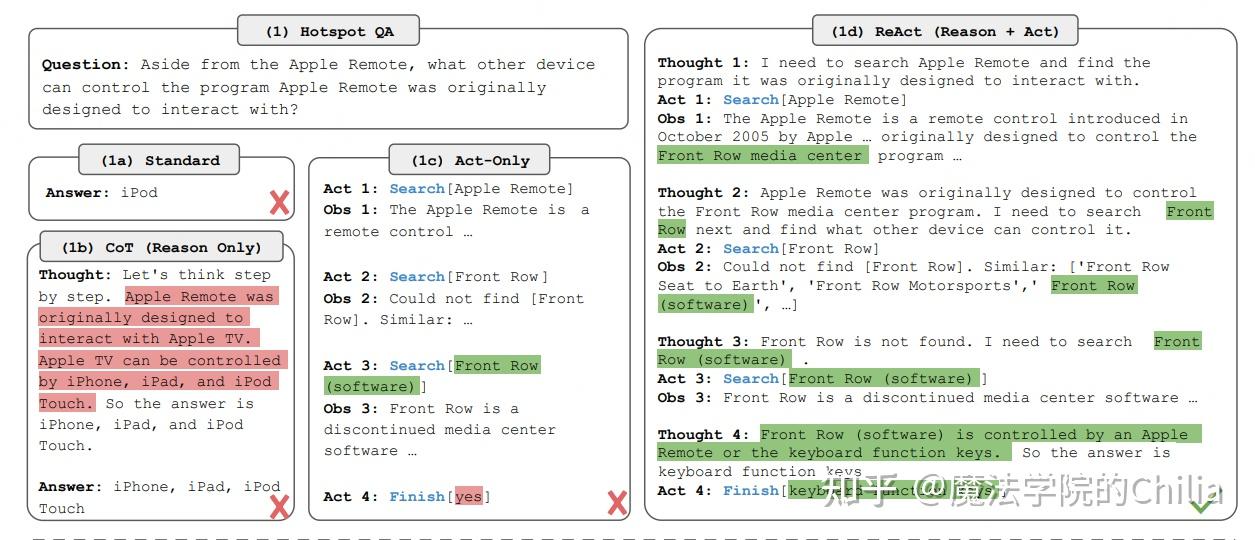
(1a) 直接输出答案;(1b) 先思考再输出答案 (1c) 只调用工具 (1d) ReAct:在调用工具之前先思考
在Agent框架下,Agent 会不断地与环境交互。 具体地,在时间步
- Observation(观察):Agent执行一个动作之后的运行结果,比如执行一次数据库查询,Observation就是查询的结果。
- Action(动作):Agent调用的工具,比如search、click等
传统策略(Act-only)通常是学习一个映射 search[query], click[button])。
ReAct 的核心创新在于扩充了动作空间:
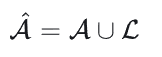
其中
- Thought:
\hat{a}_t \in \mathcal{L}。这是一个内部动作,帮助 Agent 整理思路、分解目标或提取关键信息。它不会影响外部环境,因此没有对应的观察反馈。
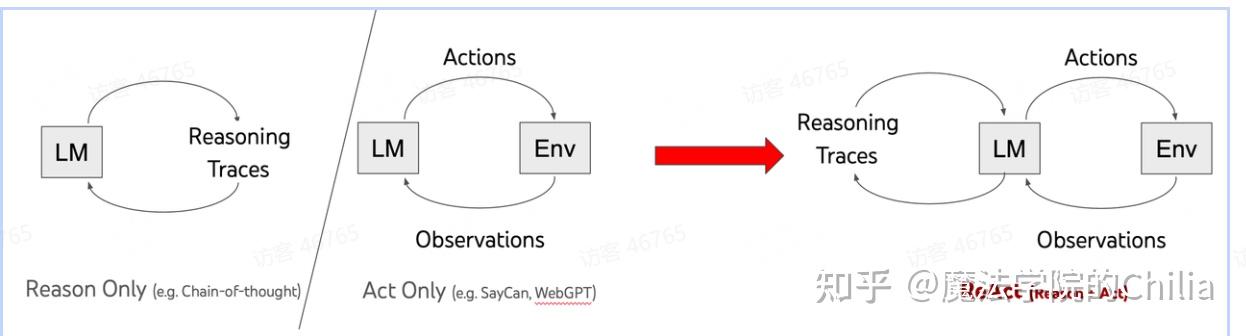
Reason-only: 直接输出,不调用工具;Act-only: 只输出调用工具的Action;ReAct: 在输出调用工具的Action之前,先进行思考
Agent的运行轨迹就是交替Thought -> Action -> Observation -> Thought ...
这个做法在现在看来已经是司空见惯,尤其是在以o1、deepseek-R1为首的复杂推理模型出来之后,都是先做思考(thinking)、然后再输出答案。我们现在都知道,thinking的过程以及thinking长度对于推理结果的正确性而言是非常重要的。
不过在当时,React还是非常有开创性的。它奠定了Agent“思考”与“行动”相结合的范式,也是目前大多数自主Agent框架(如LangChain)的底层逻辑。
(2)Plan-and-Solve:规划与任务拆解,解决长程复杂任务
Plan-and-Solve Prompting: Improving Zero-Shot Chain-of-Thought Reasoning by Large Language Models
Plan-and-Solve的核心贡献是提出了“先计划再执行”的策略,解决了Agent在面临复杂目标时“走一步看一步”导致的迷失问题。
**为什么需要用Planner?**这是因为对于一些复杂的、长链路的任务(如“写一个游戏”),普通的Agent调用方式(如ReAct)往往会“走着走着就忘了要去哪”。
这时候,我们需要就Plan-and-Solve (P&S) 模式了:先制定完整的计划,再逐一执行。在这个模式里面,有两个角色:Planner和Executor。
(a) Planner: 把一个需求变成可执行步骤的“项目经理”。
Planner 把一个复杂的任务拆解成 3-5 个清晰的动作(有论文验证 plan 的步骤不能过多);并且给出不同动作的依赖关系,告诉 Agent 哪些步骤可以并行,哪些必须串行。这个本质上是创建了一个**有向无环图(DAG)**的执行计划,后续可以将这些计划分配给对应的 Agent 执行。
示例: ["1. 搜索2023年财报", "2. 提取净利润数据", "3. 计算同比增长率", "4. 生成图表"]
在Executor执行的过程中,Planner还需要**执行监控,**记录每个任务pending、in progress、completed的状态,每完成一步就更新状态。
P&S 最重要的地方在于动态重规划:计划并不是一成不变的,而是会根据Executor的执行情况做动态调整。假如某个步骤执行失败了,Planner需要根据失败给出原因 + 改进建议,之后进行重新规划。
1. Planner 生成初始计划 [A, B, C, D]。
2. Executor 执行 A,成功。
3. Executor 执行 B,失败(例如工具报错“数据不存在”)。
4. Executor 将失败信息反馈给 Planner。
5. Planner 被唤醒:“任务 B 失败了,看来原来的计划行不通。基于现在的观察,我需要修改后续计划。”
6. Planner 生成新计划 [B', C, D]。
7. Executor 继续执行 B'。
(可选)还可以加上human in loop,也就是当用户不满意这个plan时,可以人为去修改plan。
**(b)Executor:**拿着 Planner 给的清单,一项一项地去调工具执行。
二者的交互如下图所示:
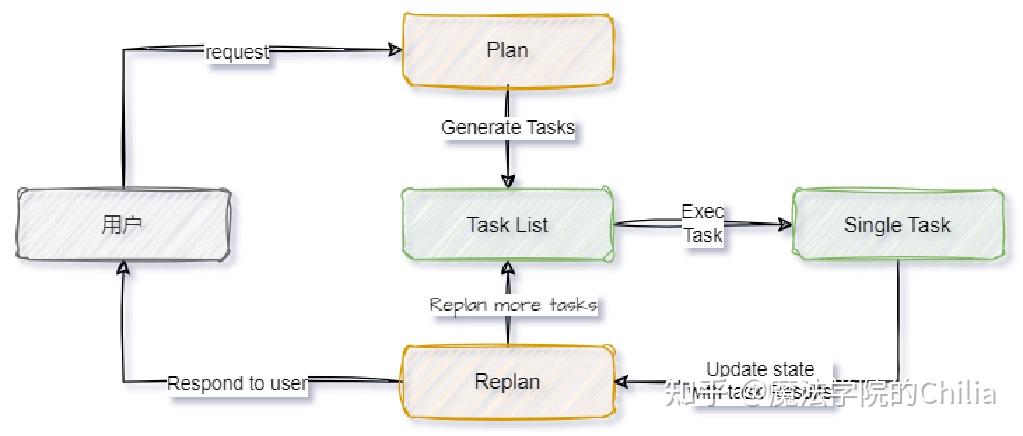
Planner与executor的交互。planner会根据实时的执行结果,动态调整plan
Plan-and-Solve论文中给出的示例如下:
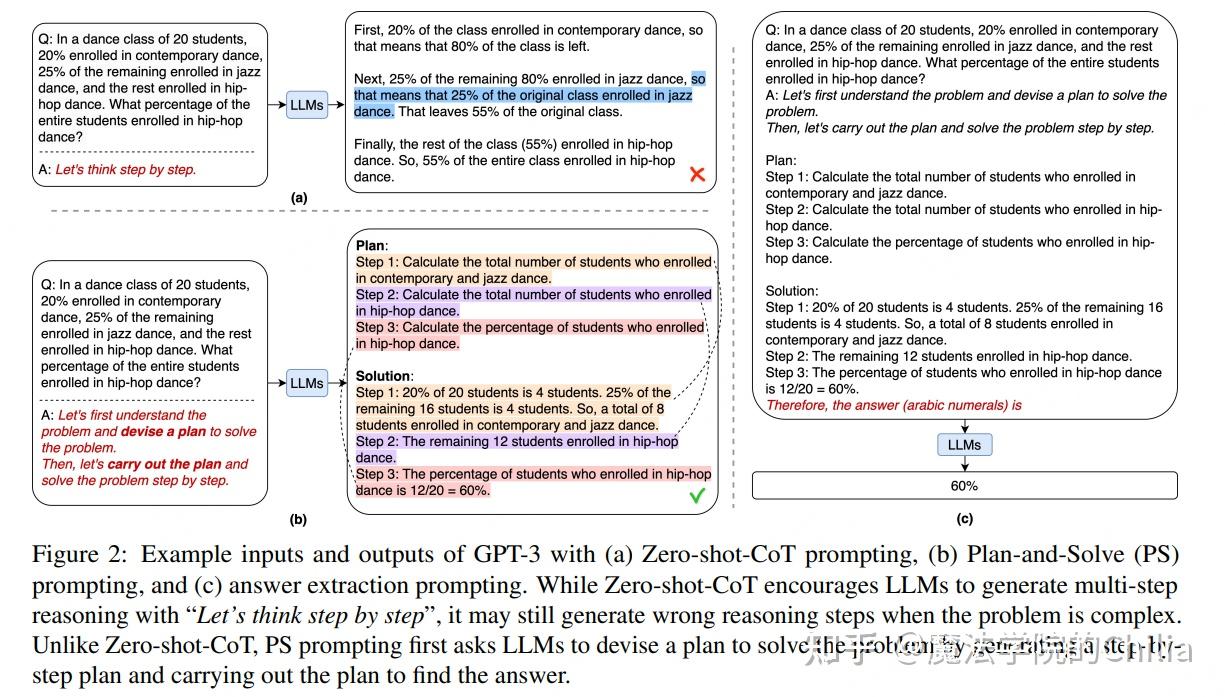
(a) 普通COT方法 (b) Plan-and-Solve, 先制定计划再一个个执行 (c) 把执行结果输给LLM,生成答案更准确
P&S在实际应用中的例子:Claude-Code
Claude Code 作为Code Agent ,也有任务规划模块。下方是Claude Code 的运行截图,prompt是"帮我生成一个打地鼠游戏",它首先做了一个任务规划,同时每执行一步都会记录并更新任务的状态("Update Todos"):
- 正在进行的任务,用彩色表示;
- 已经完成任务,用绿色表示,并用删除线划掉;
- 待办的任务,用白色表示;
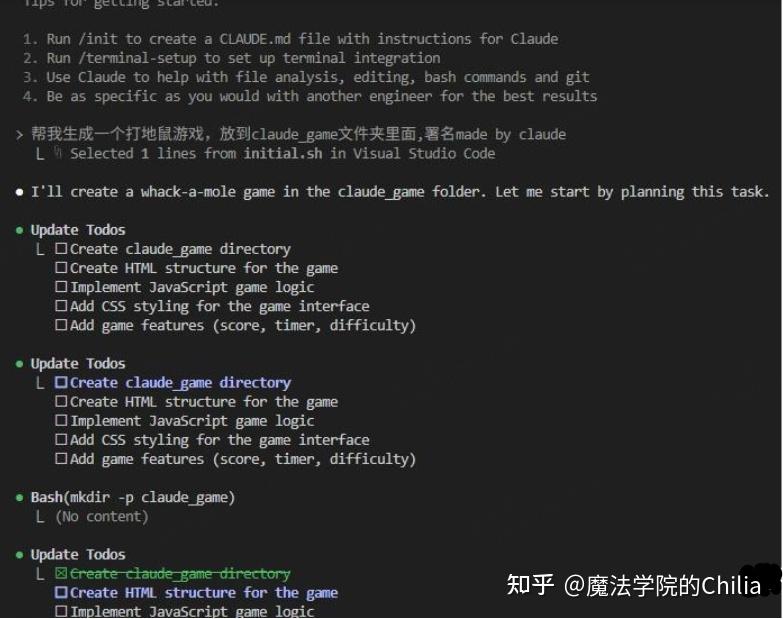
图片来源:https://zhuanlan.zhihu.com/p/1937934093762425214
(3)Reflection:自我反思与闭环控制
“在那里,人们当然可能走错路,但是那里的错误是可敬佩的,因为它含有牺牲精神。那里的工作,从全局看,有一个名称:进步。”——《悲惨世界》,雨果
代表论文:Reflexion: Language Agents with Verbal Reinforcement Learning
核心贡献:引入了动态记忆和自我反思机制,Agent会根据环境反馈评估自己的表现,并将失败经验存入记忆指导下一次尝试。这篇论文是实现自我纠错和"Plan-Execute-Observe"循环的核心论文。
Reflexion的思想很简单,就是让Agent从之前的失败中学习。Reflexion会把环境的0/1反馈(比如代码执行是否正确)或量化的反馈转换成文字描述,作为下次迭代中的额外信息,让Agent知道怎样改正错误,这样就能更好地完成任务了。
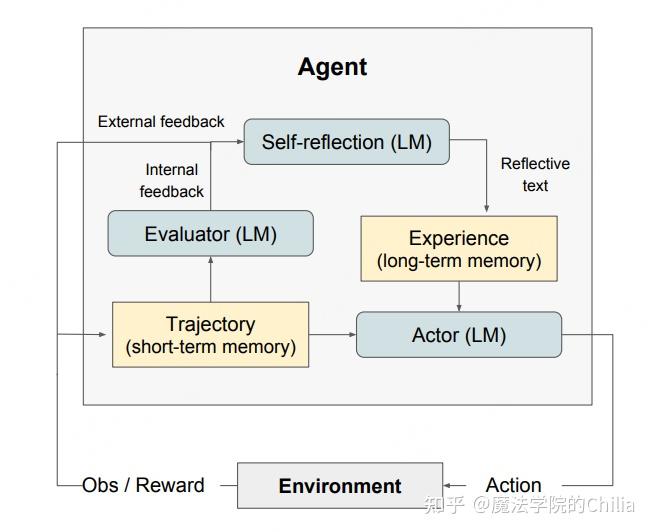
从上图看出Reflexion框架利用三个不同的模型:执行者(Actor)、评估者(Evaluator)和自我反思模型(Self-Reflection)。
- Actor基于状态和Observation生成文本和Action;
- Evaluator对Actor产生的输出计算奖励分数;
- Self-Reflection模型生成自我反思的文本分析以协助Actor自我改进。
- 该过程使用短期和长期记忆,其中轨迹历史作为短期记忆,而自我反思模型的输出存储在长期记忆中。
看下面这个示例图的中间"Programming"部分,可以对上面的流程图有一个直观的了解:
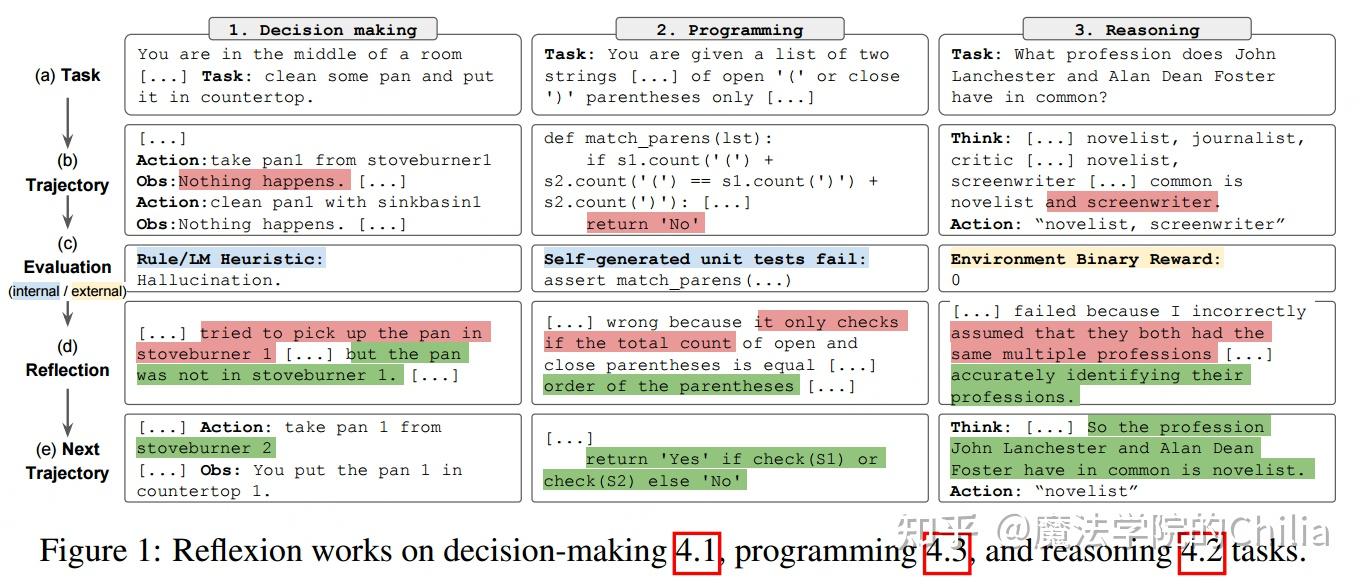
以代码生成为例,在模型拿到一个Task之后,它首先生成了一个代码段。之后,这个代码段被送给Evaluator,Evaluator会自己生成一些测试用例(self-generated unit tests)用于测试。假如这个测试失败了(assertion fail),那么Self-Reflection模型就会分析这次失败的原因,形成一个原因分析文本,再输入给模型。模型根据上一次失败的教训,会重新生成。
Self-Reflection在实际应用中的例子:swe-agent
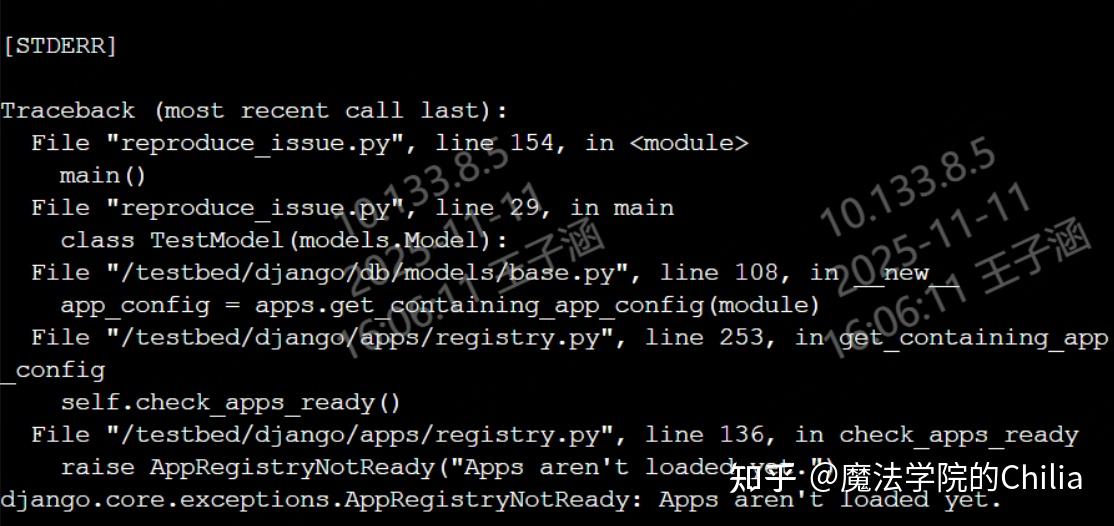
现在主流的Agent框架都不再采用上述的Actor、Evaluator、Self-Reflection三个模型了,而是用一个模型解决所有的问题。具体而言,swe-agent是一个让code-agent在其中解决真实repo中issue 报错的框架,这个code-agent可以查看文件并运行任意的代码。那么在运行代码的过程中,不可避免地会遇到一些报错。这个报错就是模型与环境交互的错误信息了,模型在下一步输出的时候,就会根据报错的信息进行分析,并修复自己的错误。比如:
在模型认为自己已经修复了issue之后,它运行下写的面的代码,想看一下自己写的代码是否有效:
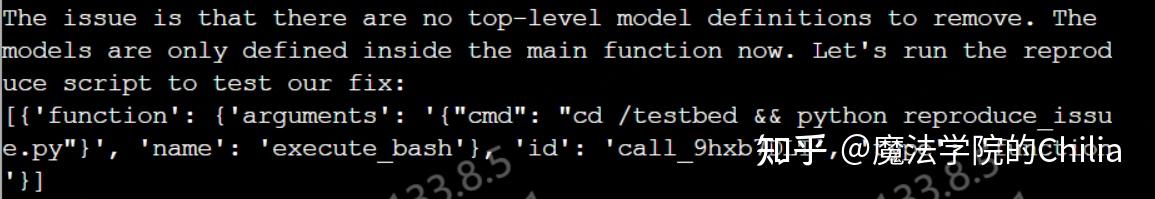
但是很不幸,它的代码出现了报错:
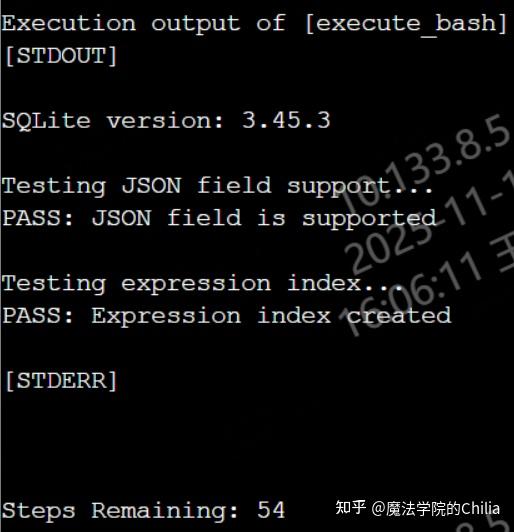
所以之后的轮次,模型就在不停地view各种文件并进行修改尝试,在经历了若干轮的toolcall->observation->toolcall->observation...之后,模型终于解决了问题:
0x03. Agent实践
(1)Agent训练数据构建(用于预训练/SFT)
step1. 工具构建
工具分为两种:
- 真实工具:调用外部真实存在的API或服务(如天气接口、数据库),返回结果是完全真实的(如实时股价)。但是缺点是开发较为复杂,需处理API认证等;另外调用成本高,频繁使用需支付API费用。
- 虚拟工具:工具功能及结果完全由LLM生成,无真实后端支持,因此不需要API认证等复杂的开发流程,也无需API费用。缺点就是结果不可信,容易编造不存在的事实、可能违反常识。
如果我们方便使用真实工具,最好还是使用真实工具的调用结果。例如,对于Code-Agent,一般都是直接在容器中执行代码,并且获得代码的执行结果。只有那种不好调用API的,才使用模拟的方式。
step2. 任务构建
可以使用大模型针对工具List合成问题,另外加入persona和场景设计,借助指令进化方法,使得Agent数据的任务变得更加接近真实使用场景,逐渐增加问题难度和多样性。最后,可以合并已有的简单任务,逐步构建复杂任务。
step3. 答案构建
搭建带可执行/模拟API调用的环境 → 智能体在环境中交互 → 记录真实调用轨迹(trajectory)作为训练数据
step4. 答案校验
为了验证构建轨迹的正确性,我们需要进行答案校验。
- 对于那种可以验证正确性的问题,我们可以用rule-based的方式来验证正确性。例如,对于code-agent任务,我们可以通过校验最终的代码是否通过测试用例来验证整个轨迹是否正确。
- 对于那种不好验证正确性的问题,我们只能用LLM judge的方式,来判断API使用是否合理、工具选择路径是否最优、参数是否合理等。
另外还有一个需要注意的一点,就是整个轨迹是正确的不代表其中每一步都是正确的,因此我们可以对其中不正确的步骤选择mask掉它的loss。例如,有的时候LLM生成的工具调用格式可能是错误的(如json无法解析、参数格式错误),那么这一步是无法调用工具的,所以这一步在SFT里面我们不去学习。另外,比如code-agent在中间的执行结果可能经常会发生报错,那么我们可以选择不去学习导致报错的轮次。
(2)Agent训练/推理的chat-template
LLMs在聊天应用场景中会由多个消息组成对话,在这些消息中,每一条都包含一个角色,比如"system"、"user"、"assistant"、"tool"
不同的模型会采用截然不同的格式进行训练。一旦模型接受了某种格式的训练,需要确保未来的输入使用相同的格式,否则就可能会出现损害性能的分布漂移。
因此,为了使用上的方便,防止由于格式不对齐导致chat模型效果有损,现在的所有模型均采用在tokenizer中预置chat template的方式固定拼接方式。
例如下面就是一个原始对话的例子:
tools = [
    {
        "type": "function",
        "function": {
            "name": "get_current_temperature",
            "description": "Get current temperature at a location.",
            "parameters": {
                "type": "object",
                "properties": {
                    "location": {
                        "type": "string",
                        "description": 'The location to get the temperature for, in the format "City, State, Country".',
                    },
                },
                "required": ["location"],
            },
        },
    }
]

messages = [
    {'role': 'system', 'content': 'You are a helpful agent. \n'},
    {'role': 'user', 'content': "现在北京的天气怎么样?"}
]
从上面的这段代码我们可以看到,它首先有一个 system 字段,描述了 LLM的身份;另外有一个第一轮问题(user 字段, "现在北京的天气怎么样?")。另外,还有一个 tools 的定义,这个就是工具列表,里面有LLM可以调用的所有工具的描述,就类似说明书一样,描述了每个工具的名称、功能描述、调用参数等。
例如上面这个工具叫 get_current_temperature,它的作用是实时获得某个地点的温度。它只接受一个传参,叫做 location,是一个string类型的地点信息,如"Beijing"。
之后,调用 apply_chat_template 将上面的对话信息变成大模型接受的string类型输入
text = tokenizer.apply_chat_template(
    messages=messages,
    tools=tools,  # 所有可调用的工具描述
    add_generation_prompt=True,
    tokenize=False
)
结果如下:
<_system>You are a helpful agent.

# 可用工具
你可以调用<tools></tools>标签中包含的一个或多个工具来辅助你回答问题,以下是可用工具详情:
<tools>
{"type": "function", "function": {"name": "get_current_temperature", "description": "Get current temperature at a location.", "parameters": {"type": "object", "properties": {"location": {"type": "string", "description": "The location to get the temperature for, in the format \"City, State, Country\"."}, "unit": {"type": "string", "enum": ["celsius", "fahrenheit"], "description": "The unit to return the temperature in. Defaults to \"celsius\"."}}, "required": ["location"]}}}
</tools>

# 调用方法
你需要遵循工具的要求,使用json格式返回工具名称及参数,并用<tool_call><tool_call>包含。下方是一个调用模板:
<tool_call>
{"name": <function-name>, "arguments": <args-json-object>}
</tool_call>
<_user>现在北京的天气怎么样?<_bot>
将上面的这个文本输入给大模型,得到返回结果:
为了获取当前天气,我需要调用\`get_current_temperature\`这个工具。

<tool_call>
{"name": "get_current_temperature", "arguments": {"location": "北京"}}
</tool_call>
之后对这个结果进行解析:
- 将<tool_call>(.*)</tool_call>中的部分提取出来,尝试使用json进行解析,确保可以提取出所调用工具的名字(name)与参数(arguments)
- 如果在<tool_call>前模型有额外输出,作为content字段一并返回给用户
- 如果解析失败,模型输出格式不规范,则需要返回提示信息给用户,并将模型输出直接放进content字段
上面结果解析之后如下:
{
    "role": "assistant",
    "content": "为了获取当前天气,我需要调用\`get_current_temperature\`这个工具",
    "tool_calls": [
        {
            "type": "function",
            "function": {
                "name": "get_current_temperature",
                "arguments": {"location": "北京"}
            }
        }
    ]
}
注意,解析的过程一般都是放在vllm里面的,所以返回给用户的结果就已经是解析之后的了。
用户获取大模型调用工具的具体信息后,需要返回给模型调用工具的结果。例如上面调用get_current_temperature API,得到北京的温度是10℃。这时候,下一步模型的输入就包含了工具调用的结果:
messages = [
    {
        "role": "system",
        "content": "You are a helpful agent. "
    },
    {
        "role": "user",
        "content": "现在北京的天气怎么样?"
    },
    {
        "role": "assistant",
        "content": "为了获取当前天气,我需要调用\`get_current_temperature\`这个工具",
        "tool_calls": [
            {
                "type": "function",
                "function": {
                    "name": "get_current_temperature",
                    "arguments": {"location": "北京"}
                }
            }
        ]
    },
    {
        "role": "tool",
        "name": "get_current_temperature",
        "content": '{"temperature": "10°C", "location": "北京"}'
    }
]
apply_chat_template之后,变成了string格式:
<_system>You are a helpful agent.
...
<_user>现在北京的天气怎么样?
<_bot>为了获取当前天气,我需要调用\`get_current_temperature\`这个工具

<tool_call>
{"name": "get_current_temperature", "arguments": {"location": "北京"}}
</tool_call><_end>

<_user><tool_response>{"temperature": "10°C", "location": "北京"}</tool_response><_bot>
用户最终得到的信息是:
{'role':'bot', 'content': '当前北京的天气为10°C。}
解决了用户的问题。
本文参考:
【万字长文】Tool Learning综述:如何让大模型学会调用外部工具
Agent学习笔记:如何实现Manus任务规划模块(Planner/Master)
Agent篇(5):思维的链条:从 ReAct 到 Plan-and-Solve —— 深度解构 Agent 的“推理引擎”
高亮
正文摘录
这周暂时停更一周大模型RL,因为有实际的需求,所以这周写了一下LLM Agent的综述,之后会继续更新RL的内容~
这篇文章是LLM Agent的基础综述,包括:
- 基本概念和总体框架
- 通过三篇经典论文了解LLM Agent的发展趋势
- LLM Agent实践:数据构建和Chat template设计
我们开始今天的内容吧!
本文共计1.3w字,预计阅读时间30分钟。
“为了达到目的,亚哈必须使用工具;而天底下所有可供使用的工具中,人这个工具是最容易失控的。”——《白鲸》,赫尔曼 · 梅尔维尔
0x01. 基本概念
(1)什么是工具?
**只要能够让语言模型从外部获得知识、或者执行操作的接口,都可以视为工具。**这些“工具”可以是一个检索引擎、一个代码执行器、一个地图 API、一个天气 API、一个与数据库交互的接口等等。
(2)为什么要使用工具?
当前大模型已经具备了很多能力,也具备了很强的理解和解决问题能力(比如内容创作、语言理解、代码生成等),但是依旧无法完成很多复杂的任务。这是因为:
首先,纯LLM的知识固化于训练语料中,一旦涉及世界最新资讯或时效性较强的数据(如天气、新闻、股票),LLM 往往会产生“幻觉”。因此相比其他确定性的工具,LLM是“最容易失控的”。这时候,通过整合搜索引擎、在线数据库、知识库等工具,模型能获得真实世界的知识和反馈,在回答用户实时问题时具有更高的准确度与时效性。
举例来说,检索增强式生成(Retrieval-Augmented Generation,RAG)就是最常见的工具之一:检索引擎可看作是一个“文本搜索”工具,我们在用户与LLM交互的时候,让LLM能够从外挂知识库中实时检索,引入丰富且正确的外部知识,避免“幻觉”式回答。
其次,大模型虽在通用场景下表现出色,但当问题需要专业技能(如复杂逻辑推理、多语言编程、多模态生成)时,仅靠自身生成的能力难以解决。如果能“外呼”专业工具(如真实执行代码、调用多模态模型等),则能大幅提升表现。
tool的类型多种多样,它们能够帮助LLM完成自己本身做不到的事情
(3)Agent基本介绍
AGENT = LLM × (规划+记忆+工具)
在这篇文章中,我们会对Agent的每个环节做较为详细的介绍。先把架构图放在这里,以便有一个整体的认知。
在这篇文章中,我们会详细介绍:
- 规划(Planning):如何将大型任务分解为较小的、可管理的子目标,以便高效的处理复杂任务;
- 反思与自我修正(Reflection & Self-critics):如何对过去的行为进行自我批评和反省,并指导接下来的行动
- 记忆(Memory)
- 短期记忆:依赖模型上下文窗口的短期记忆能力;
- 长期记忆:长期保存和调用无限信息的能力,一般通过外部载体存储和快速检索来实现。(本文不细讲)
- 工具使用(Tool use):如何调用外部 API,以获取模型权重中缺少的额外信息。
(4)Agent的不同阶段
在这里也是先放一个整体的图,以便有整体的认知。之后我们会通过经典论文和实操来了解更具体的细节。
Stage 1:Task-Planning
任务规划是指,当模型接收到用户的复杂query后,需要先进行意图理解与任务分解。先把整个问题分解成若干容易执行的小任务或步骤,并确定这些步骤的依赖关系和执行顺序,形成一个有向无环图(DAG)。
Stage 2: Tool Selection
在完成任务分解、明确了子问题后,模型需要在多个可用的工具(或API)中检索并选择最合适的工具。不同工具往往功能、输入输出方式都不同,因此正确选择不同工具组合对于成功解决子任务至关重要。
工具选择的方法也分成两类:
- **基于检索器的工具选择(Retriever-based Tool Selection)。**当工具数目庞大时,先用一个外部的检索器来筛选Top-K可能相关的工具,再把它们的描述与用户问题一并输入LLM,最终由LLM做最后的选择。这是因为模型能接受的上下文长度是有限的,如果把所有的工具都堆给它,直接就超出了上下文长度,这样肯定是不行的。常见的检索方法包括多种传统IR技术(TF-IDF/BM25)或者语义向量检索。
- **基于LLM的直接选择(LLM-based Tool Selection)**当备选的工具数量不是很多时,可以直接把工具描述全部拼接进模型输入,让LLM选出最优工具。
Stage3:Tool-Calling
在选定要用的工具后,LLMs 需要以正确的格式向工具发送调用请求,并准确填充调用参数。需要遵循工具说明中要求的格式(如参数名称、变量类型、取值范围等),否则调用会失败。
按照种类来分,工具调用分为:
- 单工具调用(Single Function Call): 如“今天天气怎么样”-> 调用
get_weather - 依赖性工具调用(Dependent Function Call):如“张三的地址处天气怎么样?”-> 先调用
get_address,然后调用get_weather - 平行工具调用(Parallel Function Call):如“张三的手机号和地址是多少?”-> 同时调用
get_address、get_phone_number
Stage4:Response Generation
工具调用完成后,LLM会收到工具调用结果,这个结果称为 Observation。接下来需要基于这个Observation与自身知识,生成最终回答给用户。
- **直接插入式(Direct Insertion Methods):**这是最简单的办法,如让模型回答时先写一句“这里是工具返回结果:ToolResult()”,然后在呈现给用户前,将“ToolResult()”替换成实际工具输出文本。这种方式往往不够灵活,也可能影响可读性,所以目前使用较少。
- **信息整合式(Information Integration Methods):**先将Observation作为上下文,继续输入LLM,让它基于这个信息写出完整、自然的答案。若工具输出过长,超出LLM的上下文窗口,会先对工具结果进行压缩或抽取。
0x02. 经典论文
(1)React(2022):奠定Agent“思考”与“行动”相结合的范式
REACT: SYNERGIZING REASONING AND ACTING IN LANGUAGE MODELS
这篇系统性地提出了将 Reasoning 与 Acting 结合的范式,也就是我们现在熟知的ReAct模式。
在 ReAct 模式提出之前,LLM的推理主要分为如下两个模式:
- 推理(Reasoning):例如 Chain-of-Thought (CoT),模型利用内部知识直接输出答案。但是这个的缺点就是模型容易产生幻觉,且无法获取外部世界的实时信息。例如问LLM“现在的美国总统是谁”,它不能实时联网搜索,用的知识都停留在训练时候的老旧数据。
- 行动(Acting): 模型根据tool-call的执行结果(Observation)直接输出下一个动作(Action)。比如下图的(1c)中,每次都根据上一轮的Observation来生成下一个动作。
(1a) 直接输出答案;(1b) 先思考再输出答案 (1c) 只调用工具 (1d) ReAct:在调用工具之前先思考
在Agent框架下,Agent 会不断地与环境交互。 具体地,在时间步
- Observation(观察):Agent执行一个动作之后的运行结果,比如执行一次数据库查询,Observation就是查询的结果。
- Action(动作):Agent调用的工具,比如search、click等
传统策略(Act-only)通常是学习一个映射 search[query], click[button])。
ReAct 的核心创新在于扩充了动作空间:
其中
- Thought:
\hat{a}_t \in \mathcal{L}。这是一个内部动作,帮助 Agent 整理思路、分解目标或提取关键信息。它不会影响外部环境,因此没有对应的观察反馈。
Reason-only: 直接输出,不调用工具;Act-only: 只输出调用工具的Action;ReAct: 在输出调用工具的Action之前,先进行思考
Agent的运行轨迹就是交替Thought -> Action -> Observation -> Thought ...
这个做法在现在看来已经是司空见惯,尤其是在以o1、deepseek-R1为首的复杂推理模型出来之后,都是先做思考(thinking)、然后再输出答案。我们现在都知道,thinking的过程以及thinking长度对于推理结果的正确性而言是非常重要的。
不过在当时,React还是非常有开创性的。它奠定了Agent“思考”与“行动”相结合的范式,也是目前大多数自主Agent框架(如LangChain)的底层逻辑。
(2)Plan-and-Solve:规划与任务拆解,解决长程复杂任务
Plan-and-Solve Prompting: Improving Zero-Shot Chain-of-Thought Reasoning by Large Language Models
Plan-and-Solve的核心贡献是提出了“先计划再执行”的策略,解决了Agent在面临复杂目标时“走一步看一步”导致的迷失问题。
**为什么需要用Planner?**这是因为对于一些复杂的、长链路的任务(如“写一个游戏”),普通的Agent调用方式(如ReAct)往往会“走着走着就忘了要去哪”。
这时候,我们需要就Plan-and-Solve (P&S) 模式了:先制定完整的计划,再逐一执行。在这个模式里面,有两个角色:Planner和Executor。
(a) Planner: 把一个需求变成可执行步骤的“项目经理”。
Planner 把一个复杂的任务拆解成 3-5 个清晰的动作(有论文验证 plan 的步骤不能过多);并且给出不同动作的依赖关系,告诉 Agent 哪些步骤可以并行,哪些必须串行。这个本质上是创建了一个**有向无环图(DAG)**的执行计划,后续可以将这些计划分配给对应的 Agent 执行。
示例: ["1. 搜索2023年财报", "2. 提取净利润数据", "3. 计算同比增长率", "4. 生成图表"]
在Executor执行的过程中,Planner还需要**执行监控,**记录每个任务pending、in progress、completed的状态,每完成一步就更新状态。
P&S 最重要的地方在于动态重规划:计划并不是一成不变的,而是会根据Executor的执行情况做动态调整。假如某个步骤执行失败了,Planner需要根据失败给出原因 + 改进建议,之后进行重新规划。
1. Planner 生成初始计划 [A, B, C, D]。
2. Executor 执行 A,成功。
3. Executor 执行 B,失败(例如工具报错“数据不存在”)。
4. Executor 将失败信息反馈给 Planner。
5. Planner 被唤醒:“任务 B 失败了,看来原来的计划行不通。基于现在的观察,我需要修改后续计划。”
6. Planner 生成新计划 [B', C, D]。
7. Executor 继续执行 B'。
(可选)还可以加上human in loop,也就是当用户不满意这个plan时,可以人为去修改plan。
**(b)Executor:**拿着 Planner 给的清单,一项一项地去调工具执行。
二者的交互如下图所示:
Planner与executor的交互。planner会根据实时的执行结果,动态调整plan
Plan-and-Solve论文中给出的示例如下:
(a) 普通COT方法 (b) Plan-and-Solve, 先制定计划再一个个执行 (c) 把执行结果输给LLM,生成答案更准确
P&S在实际应用中的例子:Claude-Code
Claude Code 作为Code Agent ,也有任务规划模块。下方是Claude Code 的运行截图,prompt是"帮我生成一个打地鼠游戏",它首先做了一个任务规划,同时每执行一步都会记录并更新任务的状态("Update Todos"):
- 正在进行的任务,用彩色表示;
- 已经完成任务,用绿色表示,并用删除线划掉;
- 待办的任务,用白色表示;
图片来源:https://zhuanlan.zhihu.com/p/1937934093762425214
(3)Reflection:自我反思与闭环控制
“在那里,人们当然可能走错路,但是那里的错误是可敬佩的,因为它含有牺牲精神。那里的工作,从全局看,有一个名称:进步。”——《悲惨世界》,雨果
代表论文:Reflexion: Language Agents with Verbal Reinforcement Learning
核心贡献:引入了动态记忆和自我反思机制,Agent会根据环境反馈评估自己的表现,并将失败经验存入记忆指导下一次尝试。这篇论文是实现自我纠错和"Plan-Execute-Observe"循环的核心论文。
Reflexion的思想很简单,就是让Agent从之前的失败中学习。Reflexion会把环境的0/1反馈(比如代码执行是否正确)或量化的反馈转换成文字描述,作为下次迭代中的额外信息,让Agent知道怎样改正错误,这样就能更好地完成任务了。
从上图看出Reflexion框架利用三个不同的模型:执行者(Actor)、评估者(Evaluator)和自我反思模型(Self-Reflection)。
- Actor基于状态和Observation生成文本和Action;
- Evaluator对Actor产生的输出计算奖励分数;
- Self-Reflection模型生成自我反思的文本分析以协助Actor自我改进。
- 该过程使用短期和长期记忆,其中轨迹历史作为短期记忆,而自我反思模型的输出存储在长期记忆中。
看下面这个示例图的中间"Programming"部分,可以对上面的流程图有一个直观的了解:
以代码生成为例,在模型拿到一个Task之后,它首先生成了一个代码段。之后,这个代码段被送给Evaluator,Evaluator会自己生成一些测试用例(self-generated unit tests)用于测试。假如这个测试失败了(assertion fail),那么Self-Reflection模型就会分析这次失败的原因,形成一个原因分析文本,再输入给模型。模型根据上一次失败的教训,会重新生成。
Self-Reflection在实际应用中的例子:swe-agent
现在主流的Agent框架都不再采用上述的Actor、Evaluator、Self-Reflection三个模型了,而是用一个模型解决所有的问题。具体而言,swe-agent是一个让code-agent在其中解决真实repo中issue 报错的框架,这个code-agent可以查看文件并运行任意的代码。那么在运行代码的过程中,不可避免地会遇到一些报错。这个报错就是模型与环境交互的错误信息了,模型在下一步输出的时候,就会根据报错的信息进行分析,并修复自己的错误。比如:
在模型认为自己已经修复了issue之后,它运行下写的面的代码,想看一下自己写的代码是否有效:
但是很不幸,它的代码出现了报错:
所以之后的轮次,模型就在不停地view各种文件并进行修改尝试,在经历了若干轮的toolcall->observation->toolcall->observation...之后,模型终于解决了问题:
0x03. Agent实践
(1)Agent训练数据构建(用于预训练/SFT)
step1. 工具构建
工具分为两种:
- 真实工具:调用外部真实存在的API或服务(如天气接口、数据库),返回结果是完全真实的(如实时股价)。但是缺点是开发较为复杂,需处理API认证等;另外调用成本高,频繁使用需支付API费用。
- 虚拟工具:工具功能及结果完全由LLM生成,无真实后端支持,因此不需要API认证等复杂的开发流程,也无需API费用。缺点就是结果不可信,容易编造不存在的事实、可能违反常识。
如果我们方便使用真实工具,最好还是使用真实工具的调用结果。例如,对于Code-Agent,一般都是直接在容器中执行代码,并且获得代码的执行结果。只有那种不好调用API的,才使用模拟的方式。
step2. 任务构建
可以使用大模型针对工具List合成问题,另外加入persona和场景设计,借助指令进化方法,使得Agent数据的任务变得更加接近真实使用场景,逐渐增加问题难度和多样性。最后,可以合并已有的简单任务,逐步构建复杂任务。
step3. 答案构建
搭建带可执行/模拟API调用的环境 → 智能体在环境中交互 → 记录真实调用轨迹(trajectory)作为训练数据
step4. 答案校验
为了验证构建轨迹的正确性,我们需要进行答案校验。
- 对于那种可以验证正确性的问题,我们可以用rule-based的方式来验证正确性。例如,对于code-agent任务,我们可以通过校验最终的代码是否通过测试用例来验证整个轨迹是否正确。
- 对于那种不好验证正确性的问题,我们只能用LLM judge的方式,来判断API使用是否合理、工具选择路径是否最优、参数是否合理等。
另外还有一个需要注意的一点,就是整个轨迹是正确的不代表其中每一步都是正确的,因此我们可以对其中不正确的步骤选择mask掉它的loss。例如,有的时候LLM生成的工具调用格式可能是错误的(如json无法解析、参数格式错误),那么这一步是无法调用工具的,所以这一步在SFT里面我们不去学习。另外,比如code-agent在中间的执行结果可能经常会发生报错,那么我们可以选择不去学习导致报错的轮次。
(2)Agent训练/推理的chat-template
LLMs在聊天应用场景中会由多个消息组成对话,在这些消息中,每一条都包含一个角色,比如"system"、"user"、"assistant"、"tool"
不同的模型会采用截然不同的格式进行训练。一旦模型接受了某种格式的训练,需要确保未来的输入使用相同的格式,否则就可能会出现损害性能的分布漂移。
因此,为了使用上的方便,防止由于格式不对齐导致chat模型效果有损,现在的所有模型均采用在tokenizer中预置chat template的方式固定拼接方式。
例如下面就是一个原始对话的例子:
tools = [
    {
        "type": "function",
        "function": {
            "name": "get_current_temperature",
            "description": "Get current temperature at a location.",
            "parameters": {
                "type": "object",
                "properties": {
                    "location": {
                        "type": "string",
                        "description": 'The location to get the temperature for, in the format "City, State, Country".',
                    },
                },
                "required": ["location"],
            },
        },
    }
]

messages = [
    {'role': 'system', 'content': 'You are a helpful agent. \n'},
    {'role': 'user', 'content': "现在北京的天气怎么样?"}
]
从上面的这段代码我们可以看到,它首先有一个 system 字段,描述了 LLM的身份;另外有一个第一轮问题(user 字段, "现在北京的天气怎么样?")。另外,还有一个 tools 的定义,这个就是工具列表,里面有LLM可以调用的所有工具的描述,就类似说明书一样,描述了每个工具的名称、功能描述、调用参数等。
例如上面这个工具叫 get_current_temperature,它的作用是实时获得某个地点的温度。它只接受一个传参,叫做 location,是一个string类型的地点信息,如"Beijing"。
之后,调用 apply_chat_template 将上面的对话信息变成大模型接受的string类型输入
text = tokenizer.apply_chat_template(
    messages=messages,
    tools=tools,  # 所有可调用的工具描述
    add_generation_prompt=True,
    tokenize=False
)
结果如下:
<_system>You are a helpful agent.

# 可用工具
你可以调用<tools></tools>标签中包含的一个或多个工具来辅助你回答问题,以下是可用工具详情:
<tools>
{"type": "function", "function": {"name": "get_current_temperature", "description": "Get current temperature at a location.", "parameters": {"type": "object", "properties": {"location": {"type": "string", "description": "The location to get the temperature for, in the format \"City, State, Country\"."}, "unit": {"type": "string", "enum": ["celsius", "fahrenheit"], "description": "The unit to return the temperature in. Defaults to \"celsius\"."}}, "required": ["location"]}}}
</tools>

# 调用方法
你需要遵循工具的要求,使用json格式返回工具名称及参数,并用<tool_call><tool_call>包含。下方是一个调用模板:
<tool_call>
{"name": <function-name>, "arguments": <args-json-object>}
</tool_call>
<_user>现在北京的天气怎么样?<_bot>
将上面的这个文本输入给大模型,得到返回结果:
为了获取当前天气,我需要调用\`get_current_temperature\`这个工具。

<tool_call>
{"name": "get_current_temperature", "arguments": {"location": "北京"}}
</tool_call>
之后对这个结果进行解析:
- 将<tool_call>(.*)</tool_call>中的部分提取出来,尝试使用json进行解析,确保可以提取出所调用工具的名字(name)与参数(arguments)
- 如果在<tool_call>前模型有额外输出,作为content字段一并返回给用户
- 如果解析失败,模型输出格式不规范,则需要返回提示信息给用户,并将模型输出直接放进content字段
上面结果解析之后如下:
{
    "role": "assistant",
    "content": "为了获取当前天气,我需要调用\`get_current_temperature\`这个工具",
    "tool_calls": [
        {
            "type": "function",
            "function": {
                "name": "get_current_temperature",
                "arguments": {"location": "北京"}
            }
        }
    ]
}
注意,解析的过程一般都是放在vllm里面的,所以返回给用户的结果就已经是解析之后的了。
用户获取大模型调用工具的具体信息后,需要返回给模型调用工具的结果。例如上面调用get_current_temperature API,得到北京的温度是10℃。这时候,下一步模型的输入就包含了工具调用的结果:
messages = [
    {
        "role": "system",
        "content": "You are a helpful agent. "
    },
    {
        "role": "user",
        "content": "现在北京的天气怎么样?"
    },
    {
        "role": "assistant",
        "content": "为了获取当前天气,我需要调用\`get_current_temperature\`这个工具",
        "tool_calls": [
            {
                "type": "function",
                "function": {
                    "name": "get_current_temperature",
                    "arguments": {"location": "北京"}
                }
            }
        ]
    },
    {
        "role": "tool",
        "name": "get_current_temperature",
        "content": '{"temperature": "10°C", "location": "北京"}'
    }
]
apply_chat_template之后,变成了string格式:
<_system>You are a helpful agent.
...
<_user>现在北京的天气怎么样?
<_bot>为了获取当前天气,我需要调用\`get_current_temperature\`这个工具

<tool_call>
{"name": "get_current_temperature", "arguments": {"location": "北京"}}
</tool_call><_end>

<_user><tool_response>{"temperature": "10°C", "location": "北京"}</tool_response><_bot>
用户最终得到的信息是:
{'role':'bot', 'content': '当前北京的天气为10°C。}
解决了用户的问题。
本文参考:
【万字长文】Tool Learning综述:如何让大模型学会调用外部工具
Agent学习笔记:如何实现Manus任务规划模块(Planner/Master)
Agent篇(5):思维的链条:从 ReAct 到 Plan-and-Solve —— 深度解构 Agent 的“推理引擎”